Problema
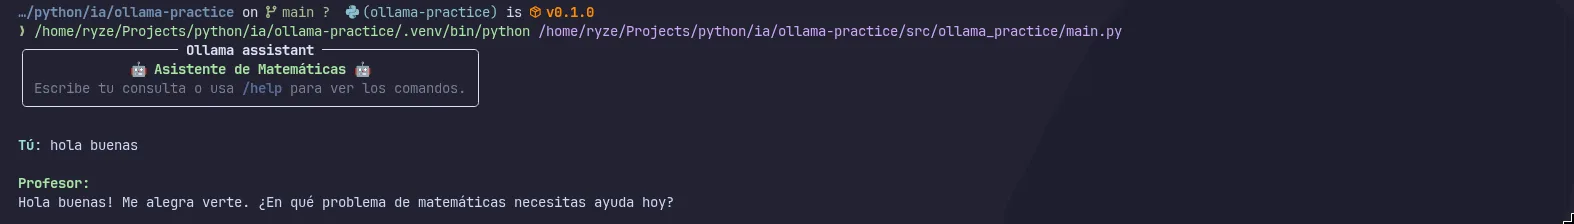
Probar modelos locales con Ollama suele reducirse a scripts básicos de terminal sin una gestión clara del contexto ni una experiencia de interacción cuidada. El proyecto busca convertir esa interacción en una herramienta CLI completa para realizar consultas matemáticas y mantener sesiones de conversación.
Solución
- Python + OpenAI SDK para desarrollar la CLI e interactuar con Ollama mediante su API compatible con OpenAI.
- Ollama para ejecutar el modelo de lenguaje localmente, evitando depender de servicios externos para las consultas.
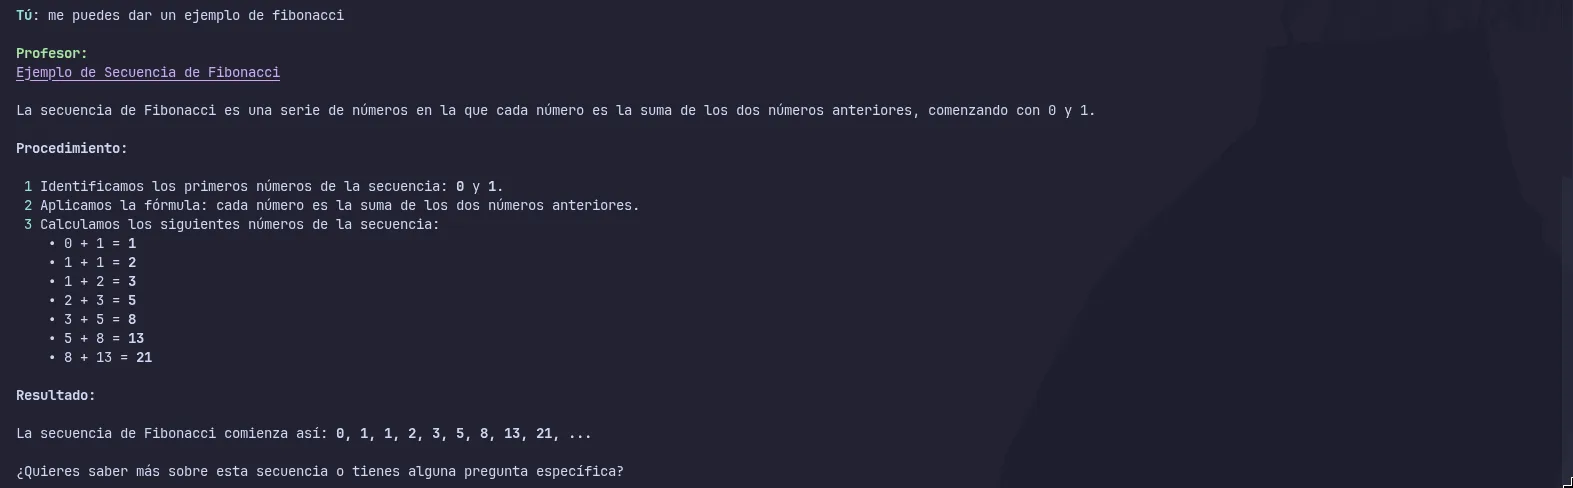
- Rich para construir la interfaz de terminal, mostrando respuestas en Markdown y permitiendo visualizar el contenido mientras se recibe mediante streaming.
- python-dotenv + dataclass para centralizar la configuración de la aplicación y cargar parámetros como el modelo, URL, tokens y tamaño del contexto desde variables de entorno.
- uv para gestionar las dependencias y el entorno de ejecución del proyecto.
Funcionalidades
- Streaming de respuestas token a token en terminal.
- Renderizado de respuestas Markdown mediante Rich.
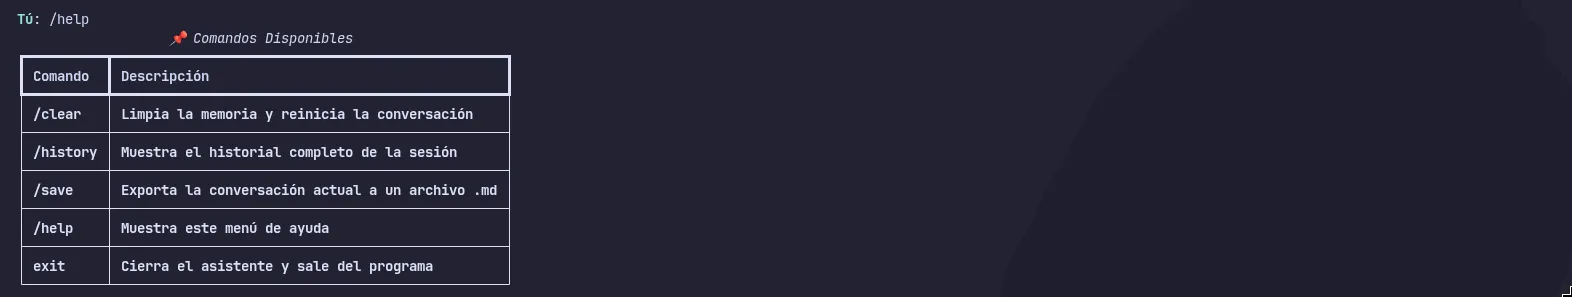
- Comandos internos para ayuda, historial, limpieza y guardado de sesiones.
- Gestión del contexto mediante sliding window.
- Conservación del system prompt al recortar el historial.
- Exportación de conversaciones a archivos Markdown.
- Timestamp UTC en las sesiones guardadas.
- Manejo de errores de conexión y API.
- Rollback del historial cuando una petición al modelo falla.
- Configuración mediante variables de entorno.
Decisiones Técnicas
La aplicación separa la interacción con el modelo de lenguaje del bucle principal de la terminal mediante un cliente específico, llamaClient. De esta forma, la lógica relacionada con Ollama queda aislada de la interfaz y de la gestión del historial.
Para controlar el consumo de contexto, el historial utiliza una sliding window que conserva siempre el system prompt y mantiene únicamente los mensajes más recientes dentro del límite configurado.
Además, el uso de streaming permite mostrar la respuesta progresivamente en la terminal en lugar de esperar a que el modelo genere toda la respuesta. Rich se encarga del renderizado de Markdown y de proporcionar una interfaz más clara durante la interacción.